Reranking در RAG چیست و چرا بدون آن نتایج جستجو هنوز ضعیفاند؟
Reranking در RAG چیست، چگونه بعد از retrieval اولیه کیفیت نتایج را بهتر میکند، و چه تفاوتی میان Cross-Encoder، MaxSim و ترتیبدهی ساده وجود دارد؟
- RAG reranking
- cross encoder reranker
- semantic reranking
- retrieval ranking
مقدمه
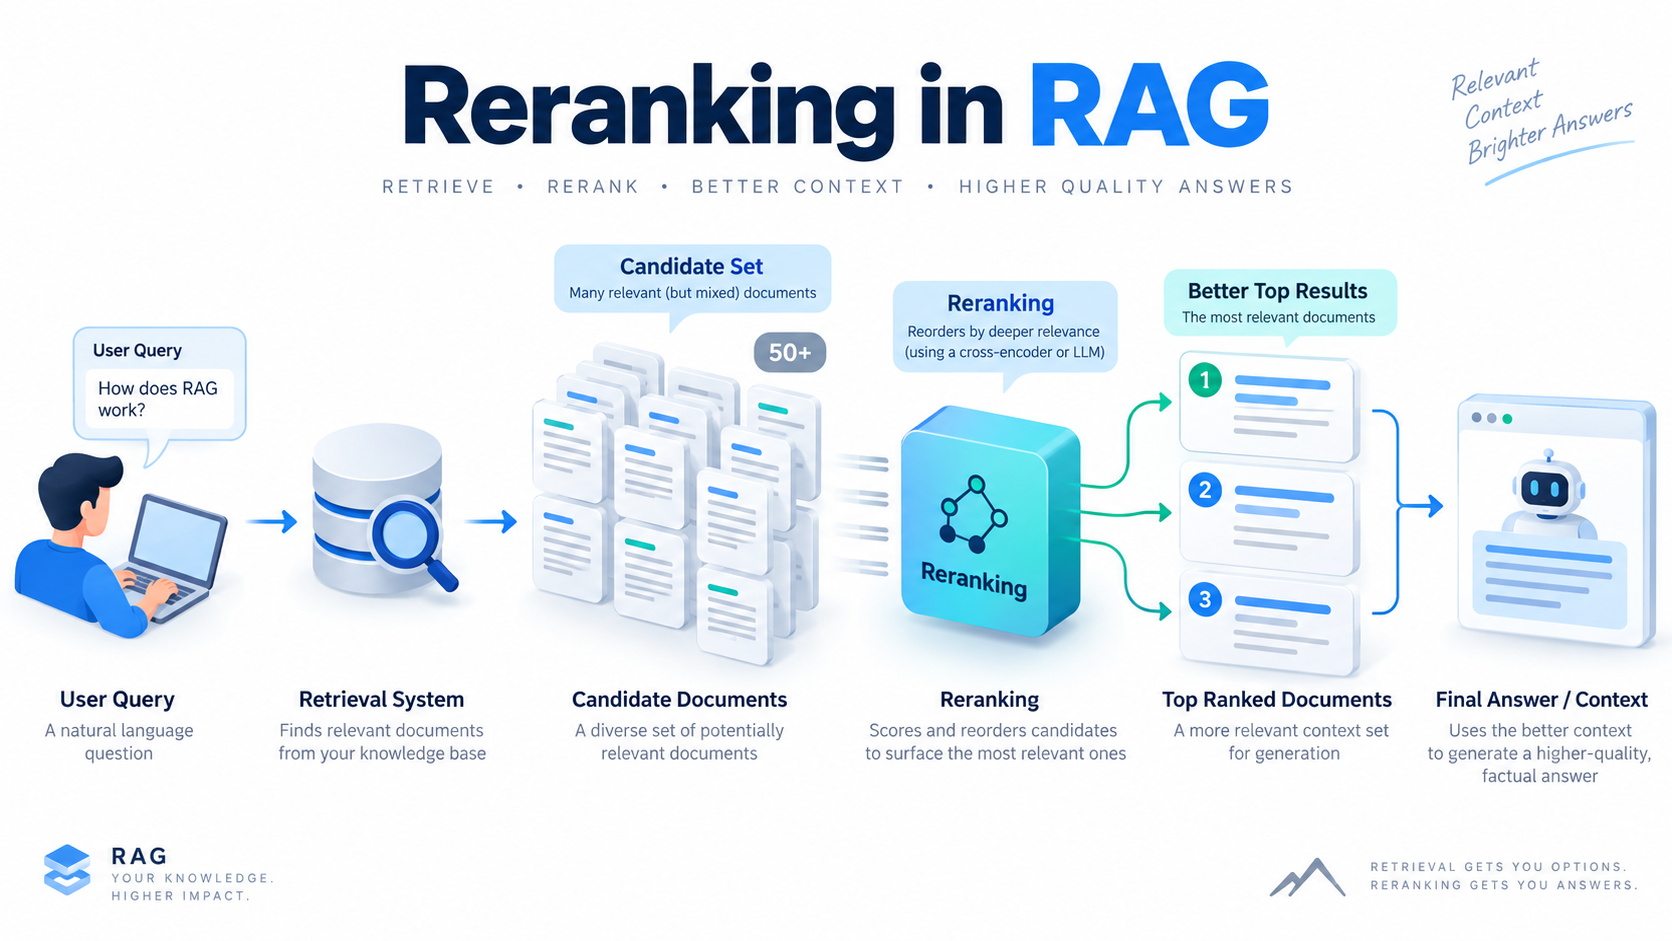
در بسیاری از پروژههای RAG، تیمها تصور میکنند اگر مرحله retrieval اولیه بهدرستی کار کند، دیگر مشکل مهمی باقی نمیماند. اما در عمل، retrieval اولیه فقط یک candidate set میسازد؛ یعنی فهرستی از اسناد یا chunkهایی که احتمالاً مرتبط هستند. این فهرست معمولاً خوب است، اما بهترین ترتیب ممکن را ندارد. همینجا است که Reranking وارد میشود.
Reranking یعنی بعد از آنکه موتور جستجو تعدادی نتیجه اولیه را پیدا کرد، یک مرحله دوم این نتایج را با دقت بیشتر دوباره بررسی و مرتب کند. در ماژولی که ساختیم، این مرحله از مهمترین جاهایی بود که باعث شد از «نتیجه قابل قبول» به «نتیجه واقعاً خوب» برسیم.
چرا retrieval اولیه کافی نیست؟
در retrieval اولیه، ما معمولاً با یک یا چند سیگنال کار میکنیم: Dense Retrieval، BM25، Exact Match یا Sparse Retrieval. این مرحله باید سریع باشد، بنابراین نمیتواند روی تکتک اسناد با مدل سنگین تصمیمگیری کند. در نتیجه چند اتفاق رایج رخ میدهد:
- سند درست داخل top-50 میآید ولی رتبه 1 نمیگیرد.
- چند نتیجه شبیه هم پشت سر هم برمیگردند.
- سندی که از نظر lexical خوب است ولی از نظر معنایی ضعیف، بیش از حد بالا میآید.
- ترتیب نتایج برای queryهای مبهم یا multi-hop دقیق نیست.
Reranker این مشکل را حل میکند، چون بهجای scan کل corpus، فقط روی candidateهای محدود کار میکند؛ مثلاً top-50 یا top-100.
Reranking چگونه کار میکند؟
الگوی رایج این است:
- Query وارد سیستم میشود.
- retrieval اولیه candidateها را پیدا میکند.
- برای هر candidate، یک مدل دقیقتر relevance را میسنجد.
- candidateها بر اساس score جدید دوباره مرتب میشوند.
این مدل دقیقتر میتواند یک Cross-Encoder، یک Late Interaction Reranker یا حتی یک مدل linear/pairwise سبک باشد.
تجربه ما در این ماژول
در نسخههای اولیه ماژول، ترکیب Dense + BM25 + Exact Match candidateهای خوبی پیدا میکرد، اما ترتیب خروجی همیشه ایدهآل نبود. بعد از اضافه کردن Reranking چند نکته مهم روشن شد:
- Reranker نباید trust score یا ACL را نابود کند. ما باگی داشتیم که در آن score جدید ممکن بود محدودیتهای سیاستی را overwrite کند.
- Reranker فقط زمانی مفید است که candidate recall کافی باشد. اگر سند درست اصلاً وارد top-100 نشده باشد، reranking کمکی نمیکند.
- اندازه rerank pool بسیار مهم است؛ top-10 برای rerank معمولاً کوچک است و top-200 برای بسیاری از کاربردها بهتر است.
Cross-Encoder در برابر Reranking ساده
یک راه ساده این است که فقط scoreهای Dense و BM25 را با وزن جدید ترکیب کنیم. این کار ارزان است، اما معمولاً از Cross-Encoder ضعیفتر است. Cross-Encoder query و document را با هم میبیند و relevance را در سطح عمیقتری میفهمد.
از طرف دیگر، اگر latency خیلی مهم باشد، reranking سبکتر یا selective reranking میتواند انتخاب بهتری باشد.
چه زمانی Reranking بیشترین اثر را دارد؟
Reranking در این شرایط بیشترین ارزش را دارد:
- corpus بزرگ است و retrieval اولیه بیشتر روی recall تمرکز دارد.
- queryهای کاربران مبهم، کوتاه یا چندبخشی هستند.
- نتایج top-k خیلی به هم شبیهاند.
- نیاز داریم سند «درستتر» نه فقط «مرتبطتر» را بالا بیاوریم.
- exact result برای پشتیبانی، FAQ یا دانش سازمانی اهمیت زیادی دارد.
هزینه و trade-off
Reranking کیفیت را بالا میبرد، اما رایگان نیست. هزینههای آن شامل این موارد است:
- latency بیشتر
- مصرف CPU/GPU بیشتر
- پیچیدگی عملیاتی بیشتر
- نیاز به profileهای مختلف برای use caseهای متفاوت
به همین دلیل ما معمولاً سه profile پیشنهاد میکنیم:
- Fast: بدون Cross-Encoder، با fusion سبک
- Balanced: top-50 → rerank → top-10
- High Quality: top-100 → rerank → diversity → context assembly
بهترین روش استفاده
برای استفاده درست از reranking، این checklist مفید است:
- Candidate Recall@50 را اندازه بگیرید.
- Rerank pool را با benchmark واقعی انتخاب کنید.
- score سیاستی و trust را جدا از relevance score نگه دارید.
- بعد از reranking، diversity و dedup را هم در نظر بگیرید.
- تاثیر reranking را روی NDCG و MRR بسنجید، نه فقط روی حس شهودی.
جمعبندی
Reranking یکی از مهمترین اجزای سیستمهای RAG حرفهای است. retrieval اولیه candidate میدهد، اما این reranker است که تصمیم میگیرد چه چیزی واقعاً باید بالاتر دیده شود. تجربه ما نشان داد که بدون reranking، حتی retrieval خوب هم میتواند خروجی متوسط تولید کند. اگر میخواهید کیفیت پاسخها در RAG بالا برود، Reranking دیگر یک قابلیت لوکس نیست؛ یک جزء کلیدی معماری است.
بهروزرسانی:
همهٔ نوشتهها