Pairwise Learning to Rank چیست و چه کاربردی در Search دارد؟
آشنایی با Pairwise Learning to Rank و تفاوت آن با امتیازدهی pointwise در سیستمهای جستجو. برای پیادهسازی عملی.
- pairwise learning to rank
- LTR search
مقدمه
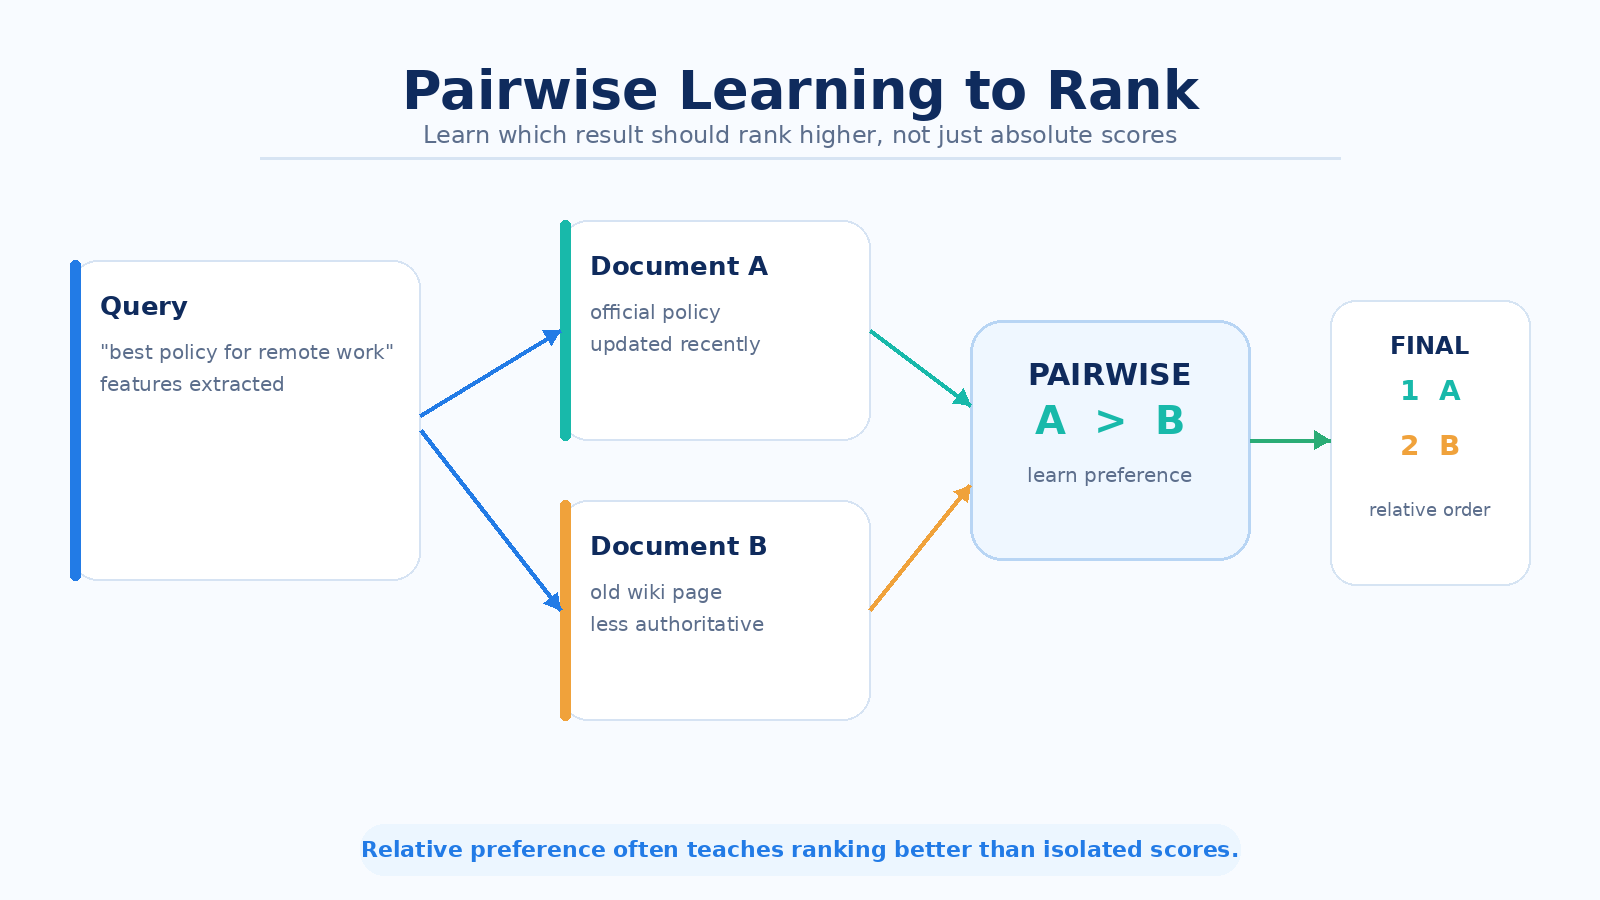
در Pairwise LTR بهجای اینکه فقط بگوییم یک نتیجه خوب است یا بد، یاد میگیریم که نتیجه A باید بالاتر از B قرار بگیرد. این مقاله مفاهیم اصلی، مزایا، محدودیتها و کاربرد آن در retrieval و reranking را توضیح میدهد.
مسئله اصلی
در سیستمهای واقعی، این موضوع فقط یک جزئیات فنی نیست، بلکه مستقیماً روی کیفیت retrieval، امنیت، پایداری یا مقیاسپذیری اثر میگذارد. در تجربه ما از ساخت و hardening ماژول Semantic Chunk Search، بارها دیدیم که نادیده گرفتن همین لایهها باعث میشود سیستم روی کاغذ خوب بهنظر برسد، اما در production رفتاری شکننده داشته باشد.
این موضوع در ماژول ما چگونه ظاهر شد؟
در ماژول، این مسئله بهصورت عملی خودش را نشان داد؛ چه در تستهای regression، چه در benchmarkهای retrieval و چه در review معماری. همین تجربه باعث شد این بخش را از یک «feature جانبی» به یک جزء مهم معماری تبدیل کنیم.
نکات طراحی و پیادهسازی
برای اینکه این قابلیت یا مفهوم واقعاً ارزش عملی داشته باشد، چند اصل مهم باید رعایت شود:
- تعریف روشن contract و interface
- ارزیابی با سناریوی واقعی، نه فقط unit test
- توجه به failure modeها و fallbackها
- جداسازی relevance از policy و security
- در نظر گرفتن latency، scale و observability
اشتباههای رایج
در این حوزه معمولاً چند اشتباه تکرار میشود: سادهسازی بیش از حد، reliance روی پیشفرضهای کتابخانهها، نداشتن benchmark واقعی، و ارزیابی ناقص با معیارهای نامرتبط. این اشتباهها در prototype چندان دیده نمیشوند، اما در production اثرشان شدید است.
کاربردهای عملی
این موضوع برای تیمهایی که روی knowledge base، RAG سازمانی، جستجوی اسناد، code retrieval، FAQهای داخلی یا پلتفرمهای چندمستاجری کار میکنند، اهمیت مستقیم دارد. حتی در پروژههای کوچک هم اگر از ابتدا درست طراحی شود، هزینه مهاجرت آینده را کم میکند.
توصیههای اجرایی
اگر بخواهیم این تجربه را به چند توصیه کاربردی تبدیل کنیم، اینها مهمتر از همه هستند:
- ابتدا baseline ساده و قابل اندازهگیری داشته باشید.
- بعد از هر تغییر، impact را روی quality و latency بسنجید.
- از همان ابتدا logging و tracing مناسب اضافه کنید.
- failure modeها را بهصورت regression test ثبت کنید.
- برای deployment واقعی، به backend، مدل و داده واقعی خودتان benchmark بگیرید.
جمعبندی
در Pairwise LTR بهجای اینکه فقط بگوییم یک نتیجه خوب است یا بد، یاد میگیریم که نتیجه A باید بالاتر از B قرار بگیرد. این مقاله مفاهیم اصلی، مزایا، محدودیتها و کاربرد آن در retrieval و reranking را توضیح میدهد. در نهایت، تفاوت بین یک سیستم خوب و یک سیستم بالغ معمولاً در همین جزئیات پنهان است. اگر این موضوع را جدی بگیرید، نهتنها کیفیت retrieval بهتر میشود، بلکه قابلیت نگهداری، اعتمادپذیری و آمادگی سیستم برای production هم بهصورت ملموسی بالاتر میرود.
بهروزرسانی:
همهٔ نوشتهها